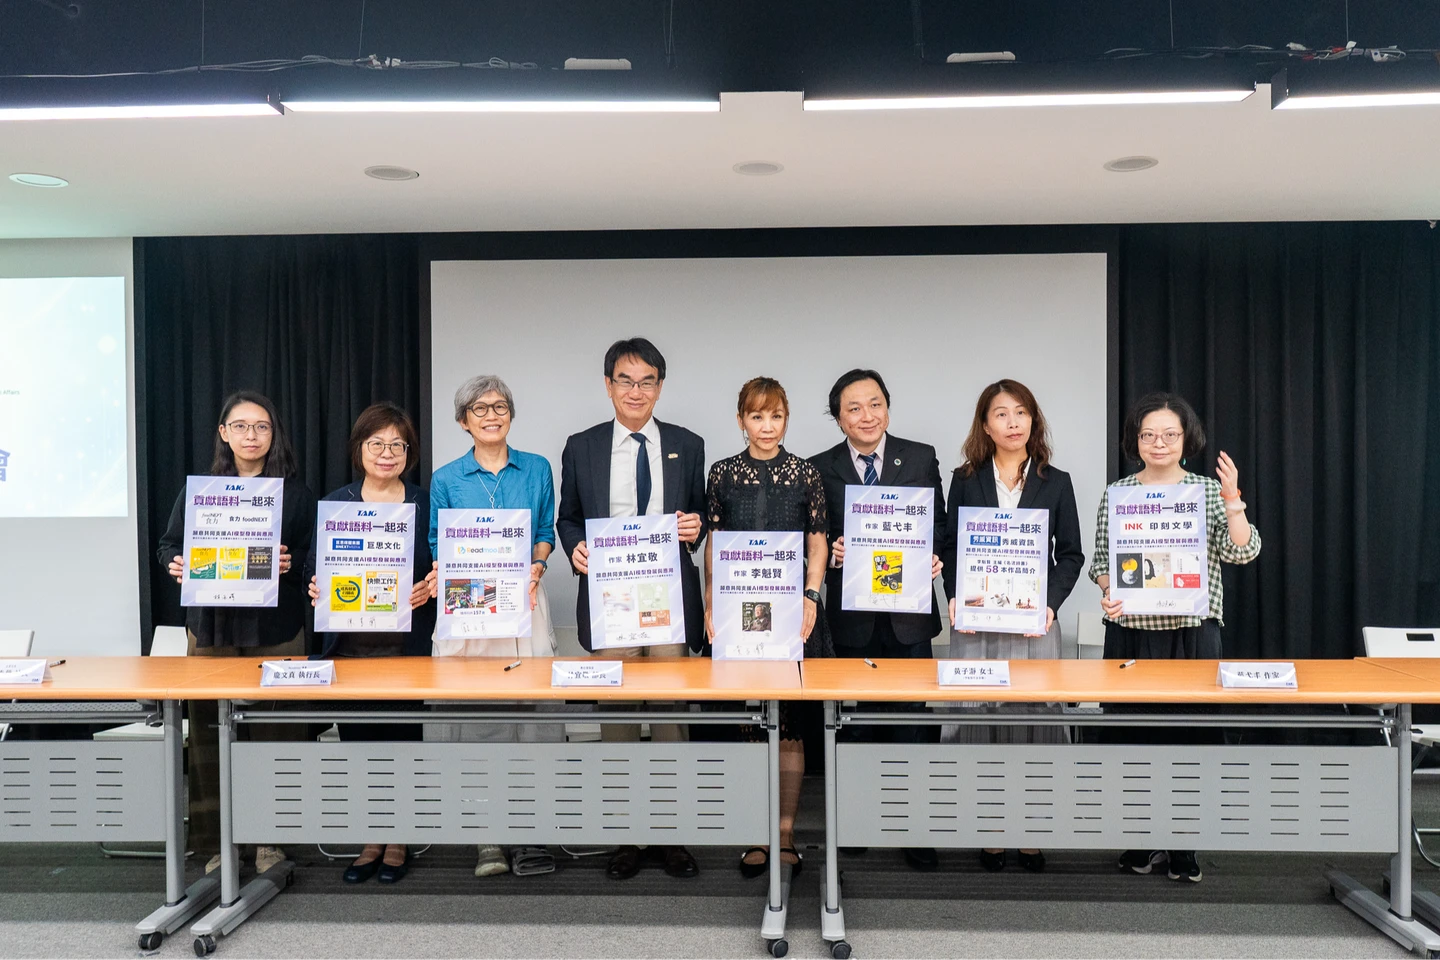
「啟動民間語料徵集」匯聚作家共襄盛舉
「啟動民間語料徵集記者會」今天在台北舉行,現場聚集了秀威資訊、印刻文學、Readmoo讀墨、食力、巨思文化等多家出版及電子書平台的代表,以及藍弋丰、李魁賢(家屬代表)等作家共襄盛舉,陳明忠、連明偉、朱國珍與朱和之等作家也提供著作響應此次徵集計畫。
林宜敬指出,AI模型對民主、權力制衡等核心概念的理解,深受訓練語料中所蘊含的社會與文化背景影響。目前國際大型語言模型的中文資料多以簡體中文為主,故若要讓AI更貼近台灣實際,必須讓台灣的語言、文化與價值納入學習內容。
「台灣主權AI訓練語料庫」至今年8月底已累積約22億Tokens
「台灣主權AI訓練語料庫」自去年底上線後,初期以中央及地方政府資料為主,截至今年8月底已累積約22億Tokens。此次民間語料徵集行動,是該語料庫發展的重要里程碑,標誌著進入全新階段。本階段將以具豐富語料資源的出版業及電子書平台合作,採用無償授權方式推廣。
🔗 延伸閱讀《林宜敬:AI算力中心BOO案 民間投資1年內達萬顆GPU》
🔗 延伸閱讀《打造「AI生態系」5大工具來了!數發部要靠千億算力、百億資金翻轉台灣》
🔗 延伸閱讀《總統盃黑客松國際松徵件啟動 數發部:運用AI打造「數位共好」新未來》
徵集內容涵蓋四大類
作者有意分享個人著作,可由出版社協助上架至語料庫。徵集內容涵蓋四大類:已授權出版品、出版品簡介、試閱內容,以及逾著作權保護期、可作為公共財活化運用之典籍與創作。 針對著作權人的權益疑慮,數位發展部強調本計畫採「自願參與、明確授權、可退出」三大原則,建立完善的授權機制及退出下架申請流程,確保在推動AI應用的同時,充分保障著作權人的意願與權利。
數發部強調,誠摯邀請作者、出版社、文化機構、法人單位及各領域內容提供者踴躍參與,攜手將更多台灣原生內容匯入,成為支持國家主權AI模型發展的重要基石。